numpy.reshapeについてメモ
多次元配列を使ってテンソル計算したいことありますよね。その時に頻出するnumpy.reshapeについて、忘備録を記しておきます。
公式リファレンス:
numpy.reshape — NumPy v1.19 Manual
numpy.reshape ですが、n次元配列の形と次元を変えることが出来ます。
使い方
numpy.reshape(a,newshape,order)
引数には、変形させたい元の配列(a)、変形後の形状(newshape)が必須で入ります。また、変形後に"どう要素を配置するか"という並べ替えの規則(order)を指定します。デフォルトは"C"という辞書式とでも言える方法ですが、この規則については以降で詳しく説明します。
並べ替えの規則①("C"の場合)
例えば、
a = np.array([[1,2,3,4], [5,6,7,8]])
みたいな、2×4の2次元配列aを考えましょう。これには8個の要素があるので、reshapeを使えば4×2の2次元配列とか、2×2×2の3次元配列とかに変形可能です。
変形前後で要素の数が合っていれば、どんな形にもできます。ですので、意味があるかは置いておいて、2×2×2×1×1みたいな5次元配列とかにも変形可能です。
さて、aを4×2の2次元配列bに変形してみます。
b = np.reshape(a,(4,2),"C")
すると、次の配列が得られます。
array([[1, 2],
       [3, 4],
       [5, 6],
       [7, 8]])
次に、2×2×2の3次元配列cに変形してみます。
c = np.reshape(a,(2,2,2),"C")
すると、次の配列が得られます。
array([[[1, 2],
        [3, 4]],
       [[5, 6],
        [7, 8]]])
2つの変換例を見ましたが、どういう規則で並び替えられているのかが問題です。(3次元以上だと表示された配列を見ても良く分からない・・・。)
これを決めるのが引数orderで、今は”C”にしていました。以下で詳しく見ていきます。
配列aの要素をindex(下付き文字)を使って表現することにします。こうすることで、多次元配列でも頭が混乱せずに済みます。
これをindex (i, j)の辞書順で並べると、以下の様になります。
さて、同様に、変換で得られた配列bを要素で表し、辞書順に並べてみます。
すると、配列aを辞書順に並べたときと一致していることが分かります。次に、配列cでもやってみると、
となり、やはりaを辞書順に並べたときと一致しています。
以上の例から分かる様に、order = "C"で変換を行うときの規則は、要素をindexの辞書順で並べたときに一致させるなのです。
ちなみに、indexと要素の対応は、
c[i-1][j-1][k-1] #-1はゼロから数えるための補正
に具体的な値を代入すれば、ひとつずつ確かめることができます。
並べ替えの規則②(”F”の場合)
またaを2x2x2の配列に変形しますが、次はorderを"F"にしてみます。こうして得られる3次元配列をdとします。
d = np.reshape(a,(2,2,2),"F")
dは以下の様になります。
array([[[1, 3],
        [2, 4]],

       [[5, 7],
        [6, 8]]])
dの要素をindexの辞書順で並べてみます。
aの要素と比べると、次の関係が成り立っていることが分かります。
左辺は辞書順に並んでいますが、右辺は辞書順になっていません。では、aからdへの変換は、どういう規則で行われているのでしょうか。
実は、”左読みの辞書順”で並ぶようになっています。ここで左読みと言っているのは、普通に横書きの文章を読むのとは逆方向、例えば”123”を百二十三と読むのではなく、三百二十一と読むという意味です。
dの要素をindexの”左読みの辞書順”で並び替えましょう。
さらに、右辺をaの要素を使って書き換えると、
となります。
ちゃんと両辺共に”左読みの辞書順”に並んでいることが分かりますね。
”C"と”F”の違いと、”A”について
実は、これまでに見てきた並べ替えの規則は、配列をメモリにどう保存するかという規則と関係しています。
配列は1次元(ただの数値の並び)に変換されてメモリに保存されるのですが、そのときindexの辞書順(C流)に並べるか、逆読み辞書順(Fortran流)に並べるかという2通りがあります。メモリにはこの並べ方の情報も同時に記録されます。ちなみに、numpy.arrayはデフォルトではC流になります。
reshapeのorderに"C"や”F”を指定した時は、変形前の配列がC流で保存されているかFortran流で保存されているかに関わらず、規則に沿って並び替えを行います。例えば”C”を入れると、配列はC流で保存されているものとみなし、変換もC流に従って行うことになります。同様に、”F”を指定すれば、元の保存形式が何であれFortran流で読み書きされます。一方、orderには”A”というオプションも存在し、ここでは保存されている規則を判別し、それに従って変換を行います。
ちなみに、配列aがどの規則で保存されているかは、例えば、
a.flags
で確認可能です。
以上です。
簡単な矢印を描く
matplotlibを使ってグラフを描画するとき、ある点から別の点を結ぶ矢印を入れたくなる時があります。
使う頻度は高くないですが、低くもない。また忘れたときにコピペするために、メモしておきます。
参考にした公式マニュアルのページ:
matplotlib.axes.Axes.arrow — Matplotlib 3.0.3 documentation
matplotlib.axes.Axes.annotate — Matplotlib 3.0.3 documentation
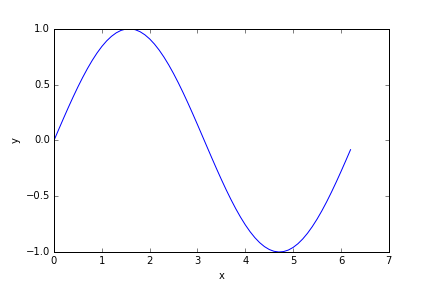
サイン波のグラフを描いておきましょう。
import numpy as np
from matplotlib import pyplot as plt

fig, ax = plt.subplots(1,1,figsize=(6,4))
x = np.arange(0,2*np.pi,0.1)
ax.plot(x,np.sin(x))
ax.set_xlabel('x')
ax.set_ylabel('y')
arrow
一番簡単なのはこれでしょうか。axesクラスのarrow。
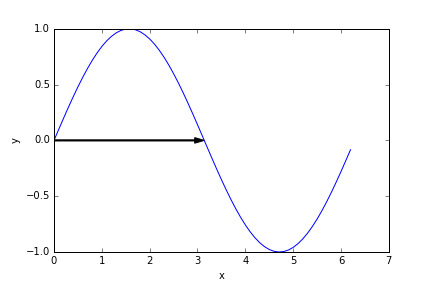
僕の場合、凝った矢印はあまり使わないので、例えば下記を上のコードに加えてプロットしてみます。
ax.arrow(x=0,y=0,dx=np.pi,dy=0,width=0.01,head_width=0.05,head_length=0.2,length_includes_head=True,color='k')
出力は、こうなります。
注意点が3点
① widthとhead_width、head_lengthのデフォルト値。
width(矢印の棒の部分の幅):0.001。単位はポイントではない。
head_width(矢の部分の幅):widthの3倍というデフォルト値が設定されています。
head_length(矢の部分の長さ):head_widthの1.5倍。
初めて使ったときはデフォルトの挙動に悩まされました。
② length_includes_headはデフォルトでFalseなので、先っちょを指定した終点に合わせたいときはTrueにしましょう。
③ axes.arrowで描いた矢印はaxisの大きさに合わせて太さ大きさが変わります。
※後日追記:サイズはデータの座標が使われます。
annotate
注釈用のannotateも(もちろん)矢印を書くのに使えます。
かなり多機能なのですが、ここでは、ただ矢印を描くだけに使います。
使い方は例えば、
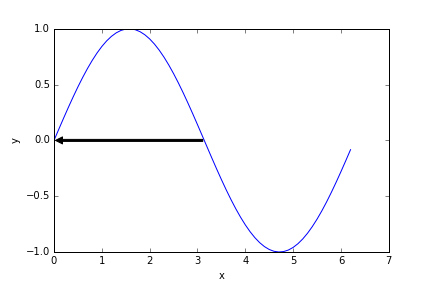
ax.annotate(s='',xy=(0,0),xytext=(np.pi,0),xycoords='data',\
            arrowprops=dict(facecolor='black', width =2.0,headwidth=7.0,headlength=7.0,shrink=0.01))
引数のsは注釈用コメントですね。今は空にしてますが。
コメント位置(xytext)からxyに向かって矢印が引かれます。
xycoordsは座標の指定で、デフォルトでdataです。他にも、例えば'axes fraction'(axisの割合)とかを指定できます。
arrowpropsでは、矢印の見た目に関する指定をします。大きさに関しては、上で見たarrowと違って、ポイント数で指定できます。shrinkは矢印の長さをどのくらい縮めるかで、端から端まで引きたいときは0にします。
サイン波に重ねて出力した結果がこちらです。
矢印の頭の形状を変えたいときは、arrowpropsでarrowstyleを指定します。
例えば、
ax.annotate(s='',xy=(0,0),xytext=(np.pi,0),xycoords='data',\
            arrowprops=dict(facecolor='black',arrowstyle='<-, head_width=0.5',lw=3,shrinkA=0,shrinkB=0))
で、出力結果がこちら、

ここで注意すべき点が、arrowstyleを指定すると、widthとかheadwidthを指定することができなくなるということです。なぜか、arrowstyleに文字列で入力することになります。
あと、PathPatchを使って、線の太さ(linewidth; lw)とか種類(linestyle; ls)を指定することもできます。
shrinkAとBはそれぞれ、始点(xytext)と終点(xy)と矢印の隙間をポイント数で指定します。
・・・疲れたので、以上にします。
ndarrayの連結
numpyのndarrayを連結して1つのndarrayにしたい。そんなとき、僕はnumpyの関数であるconcatenate, stack, vstack, hstack, appendなどを良く使います。それぞれの用法について、メモしておきます。
最後まで読んで下さった方には言うまでもないかもしれませんが、内容は公式マニュアルから必要な部分を抜粋し、まとめたものに過ぎません。
手始めにndarrayをいくつか初期化しておきます。
import numpy as np

a = np.array([[1,2],[3,4]])
b = np.array([[5,6],[7,8]])
c = np.array([[1,2],[3,4],[5,6]])
全て2次元の配列で、a,bはともに2行2列、cは3行2列です。
1. concatenate
さて、まずはconcatenateです。a,bを次の様に連結してみます。
np.concatenate([a,b],axis=0)
実行結果は、
array([[1, 2],
       [3, 4],
       [5, 6],
       [7, 8]])
となります。4行2列の2次元配列が返されます。
引数axisは連結の方向を指定します。0だと行が増え、1だと列が増える方向です。
ここで、大きさの異なる配列同士の連結を考えましょう。例えば、配列aとcは列の数は同じですが、行の数が異なります。この時、axis=0でconcatenateは可能ですが、axis=1ではエラーとなり実行できません。
また、concatenateは連結によって次元を上げることは出来ないので、2次元配列同士をaxis=2方向に連結することは出来ません。
2. stack
次はstackを見てみましょう。a,bをstackで連結してみます。
np.stack([a,b],axis=0)
実行結果は、
array([[[1, 2],
        [3, 4]],

       [[5, 6],
        [7, 8]]])
となります。この配列は3次元で、大きさは(2,2,2)になります。この例から分かるように、stackは次元を上げます。2つの配列を重ねるイメージです。
別のaxisを指定してみましょう。
np.stack([a,b],axis=1)
実行結果は、
array([[[1, 2],
        [5, 6]],

       [[3, 4],
        [7, 8]]])
となります。大きさは変わらず(2,2,2)ですが、配列の重なり方が先ほどの例とは異なります。axisは配列を重ねる方向を指定するといえるでしょう。
stackは異なる大きさの配列を連結することはできません。この例だと、配列aとcは連結できません。
やろうとすると、すべての入力配列の大きさを合わせろと怒られます。
ValueError: all input arrays must have the same shape
3. vstack, hstack
vstackとhstackですが、名前に惑わされてはいけません。できることはconcatenateと同様です。
vstackとhstackは引数にaxisを取りません。vstackはconcatenateでaxisを0に指定したもの、hstackはaxisを1に指定したものと同じです。
使い方は、
np.vstack([a,c])
こんな感じです。
4. append
最後にappendについて書きます。その名の通り、元の配列に別の配列を付け加えます。
appendはaxisを指定できますが、まずは指定せずにやってみます。
np.append(a,b)
実行結果は、
array([1, 2, 3, 4, 5, 6, 7, 8])
となります。
この様に、axisを指定しないと、元が多次元配列でも1次元にされてしまいます。
公式リファレンスには、"If axis is None, out is a flattened array."と書いてあります。
axis=0を指定してやれば、
array([[1, 2],
       [3, 4],
       [5, 6],
       [7, 8]])
この様に、concatenateと同様に働いてくれます。
以上、僕が良く使うndarrayの連結方法についてメモしておきました。
テスト
これはテストです。
import numpy as np

x = np.array([1,2,3])
